

Comment vous assurez-vous que vos solutions d’IA fonctionnent comme prévu ?
Une brève introduction aux évaluations d'IA
L'intelligence artificielle générative (GenAI) évolue rapidement et ne se limite plus aux chatbots ludiques ou à la génération d'images impressionnantes. En 2025, l'accent sera mis sur la transformation du battage médiatique autour de l'IA en valeur ajoutée concrète. Partout dans le monde, les entreprises cherchent à intégrer et à exploiter la GenAI dans leurs produits et processus afin de mieux servir leurs utilisateurs, d'accroître leur efficacité, de rester compétitives et de stimuler leur croissance. Grâce aux API et aux modèles pré-entraînés proposés par les principaux fournisseurs, l'intégration de la GenAI semble plus simple que jamais. Mais attention : la facilité d'intégration ne garantit pas le bon fonctionnement des solutions d'IA une fois déployées.
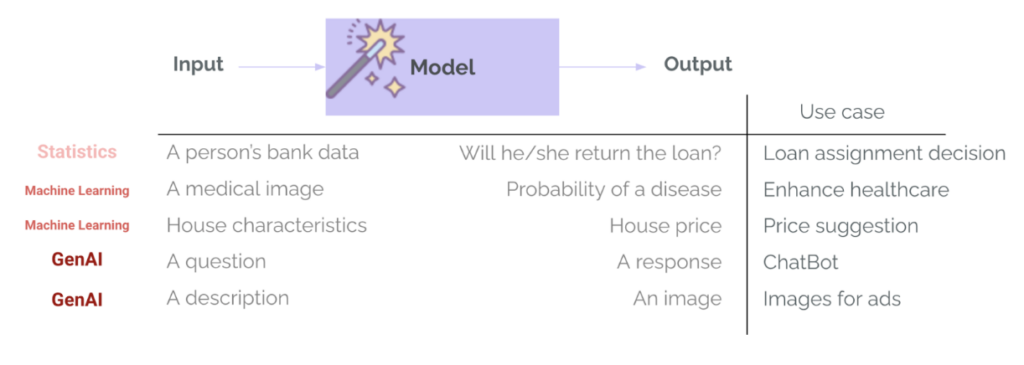
Les modèles prédictifs ne sont pas vraiment nouveaux : en tant qu’êtres humains, nous faisons des prédictions depuis des années, officiellement depuis les statistiques. Cependant, l’IA générale a révolutionné la prédiction pour plusieurs raisons :
- Vous n’avez pas besoin de former votre propre modèle ou d’être un data scientist pour créer des solutions d’IA.
- L’IA est désormais facile à utiliser via des interfaces de chat et facile à intégrer via des API.
- Libérer de nombreuses choses qui n’étaient pas possibles à faire ou qui étaient vraiment difficiles à faire auparavant.
Tous ces éléments rendent l'IA générale incroyablement passionnante, mais aussi risquée . Contrairement aux logiciels traditionnels, voire à l'apprentissage automatique classique, l'IA générale introduit un nouveau niveau d'imprévisibilité. Il ne s'agit pas d'implémenter une logique déterministe, mais d'utiliser un modèle entraîné sur d'énormes quantités de données, en espérant qu'il réagira comme prévu. Comment savoir alors si un système d'IA fonctionne comme prévu ? Comment savoir s'il est opérationnel ? La réponse réside dans les évaluations, un concept que nous explorerons dans cet article.
- Pourquoi les systèmes Genai ne peuvent pas être testés de la même manière que les logiciels traditionnels ou même l'apprentissage automatique classique (ML)
- Pourquoi les notes sont essentielles pour comprendre la qualité de votre système d'IA et non facultatives (à moins que vous n'aimiez les surprises)
- Différents types d'évaluations et techniques pour les appliquer dans la pratique
Que vous soyez chef de produit, ingénieur ou toute personne travaillant avec l'IA ou s'y intéressant, j'espère que cet article vous aidera à comprendre comment réfléchir de manière critique à la qualité des systèmes d'IA (et pourquoi les évaluations sont essentielles pour atteindre cette qualité !).
L’IA générative ne peut pas être testée comme un logiciel traditionnel, ni même comme l’apprentissage automatique classique.
Dans le développement logiciel traditionnel , les systèmes suivent une logique déterministe : si X se produit, alors Y se produira, systématiquement. Sauf en cas de problème avec le système sous-jacent ou d'introduction d'un bug dans le code… C'est pourquoi les tests, la surveillance et les alertes sont indispensables. Les tests unitaires servent à valider de petits blocs de code, les tests d'intégration à garantir le bon fonctionnement des composants et la surveillance à détecter les dysfonctionnements en production. Tester un logiciel traditionnel, c'est comme vérifier une calculatrice : on entre 2 + 2, et on s'attend à obtenir 4. C'est clair et déterministe : le résultat est soit vrai, soit faux.
Cependant, l'apprentissage automatique et l'intelligence artificielle introduisent l'indétermination et la probabilité. Au lieu de définir explicitement un comportement par des règles, on entraîne des modèles à apprendre des schémas à partir des données. En IA, si X se produit, la sortie n'est plus un Y fixe, mais une prédiction assortie d'un certain degré de probabilité, basée sur ce que le modèle a appris pendant son entraînement . Cela peut s'avérer très puissant, mais cela introduit également de l'incertitude : des entrées identiques peuvent donner des sorties différentes au fil du temps, des sorties plausibles peuvent être erronées et des comportements inattendus peuvent apparaître dans de rares cas.
Cela rend les méthodes de test traditionnelles inadéquates, voire parfois impraticables. L'exemple de la calculatrice est comparable à l'évaluation des performances d'un étudiant lors d'un examen à questions ouvertes. Pour chaque question, et pour les nombreuses réponses possibles, la réponse fournie est-elle correcte ? Est-elle supérieure au niveau de connaissances attendu de l'étudiant ? L'étudiant a-t-il tout inventé, mais de manière très convaincante ? À l'instar des réponses à un examen, les systèmes d'IA peuvent être évalués, mais ils nécessitent une méthode plus générale et flexible pour s'adapter à différentes entrées, contextes et cas d'utilisation (ou types de tests).
En apprentissage automatique traditionnel , l'évaluation est une étape incontournable du cycle de vie d'un projet . L'entraînement d'un modèle sur une tâche spécifique, comme l'approbation de prêts ou la détection de maladies, inclut systématiquement une phase d'évaluation, à l'aide de métriques telles que la précision, le rappel, l'erreur quadratique moyenne (RMSE) et l'erreur absolue moyenne (MAE). Cette évaluation permet de mesurer les performances du modèle, de comparer différentes options et de déterminer s'il est suffisamment performant pour être déployé. En intelligence artificielle de génération (GenAI), l'approche est généralement différente : les équipes utilisent des modèles déjà entraînés et ayant passé avec succès des évaluations internes réalisées par le fournisseur du modèle et sur des benchmarks généraux. Ces modèles excellent dans les tâches générales, comme répondre à des questions ou rédiger des e-mails, et il existe un risque de dépendance excessive à leur égard pour notre cas d'usage spécifique. Il est donc essentiel de se demander : « Ce modèle, aussi performant soit-il, est-il adapté à mon cas d'usage ? » C'est là que l'évaluation intervient : elle permet de déterminer si les prédictions ou les générations sont pertinentes pour le cas d'usage, le contexte, les entrées et les utilisateurs spécifiques.
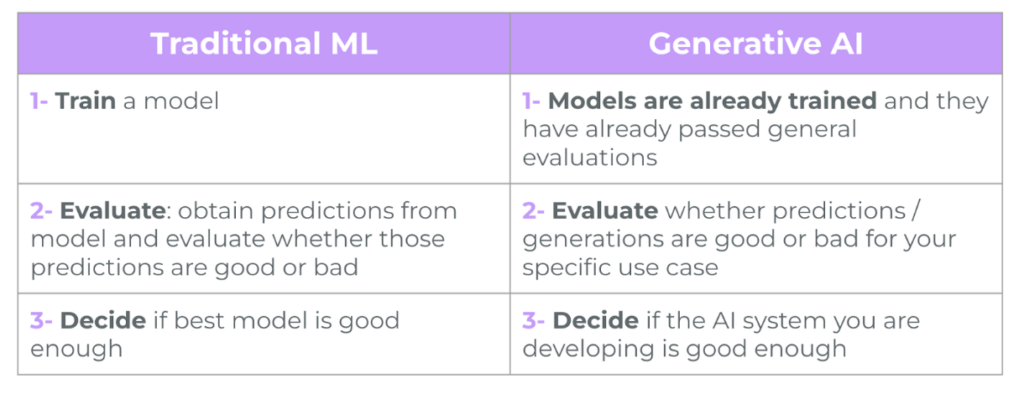
Il existe une autre différence majeure entre ML et GenAI : la variété et la complexité des résultats du modèle. Nous ne renvoyons plus de catégories et de probabilités (comme la probabilité qu'un client rembourse un prêt), ni de chiffres (comme le prix attendu d'une maison en fonction de ses caractéristiques). Les systèmes GenAI peuvent renvoyer de nombreux types de sorties, avec des longueurs, des tons, des contenus et des formats différents. De même, ces modèles ne nécessitent plus d’entrées hautement structurées et spécifiques, mais acceptent généralement presque n’importe quel type d’entrée : texte, images, voire audio ou vidéo. L’évaluation devient alors beaucoup plus difficile.
Pourquoi les évaluations sont nécessaires et non facultatives (à moins que vous ne préfériez les mauvaises surprises)
Les processus d'évaluation vous aident à déterminer si votre système d'IA fonctionne comme prévu , s'il est opérationnel et, le cas échéant, s'il continue de fonctionner comme prévu. Voici une analyse expliquant l'importance des processus d'évaluation :
- Évaluation de la qualité : Les évaluations fournissent un moyen structuré de comprendre la qualité de vos prédictions ou résultats d’IA et comment ils s’intégreront dans le système global et le cas d’utilisation. Les réponses sont-elles exactes ? Utile? Cohésif? En rapport?
- Quantifier les erreurs : Les notes aident à déterminer le pourcentage, les types et l’ampleur des erreurs. À quelle fréquence les erreurs se produisent-elles ? Quels types d’erreurs se produisent le plus fréquemment (par exemple, faux positifs, hallucinations, erreurs de format) ?
- Atténuation des risques : Il vous aide à détecter et à prévenir les comportements nuisibles ou biaisés avant qu'ils n'atteignent les utilisateurs, protégeant ainsi votre entreprise des risques de réputation, des problèmes éthiques et des problèmes réglementaires potentiels.
L'IA générative, avec des relations d'entrée-sortie libres et une génération de texte long, rend les évaluations plus pertinentes et plus complexes. Quand les choses tournent mal, elles peuvent très mal tourner. Nous avons tous vu les gros titres sur les chatbots offrant des conseils dangereux, les modèles générant du contenu biaisé et les outils d’IA hallucinant de faux faits.
« L’intelligence artificielle ne sera jamais parfaite, mais en utilisant des systèmes de notation, vous pouvez réduire le risque d’embarras – qui pourrait vous coûter de l’argent, de la crédibilité, ou un buzz viral sur Twitter. »
Comment définir une stratégie d’évaluation de l’IA ?
Alors, comment déterminons-nous nos notes d’IA ? Il n’existe pas de méthode d’évaluation universelle. Les évaluations dépendent du cas d’utilisation spécifique et doivent s’aligner sur les objectifs spécifiques de votre application d’IA. Par exemple, si vous créez un moteur de recherche, vous vous soucierez peut-être de la pertinence des résultats. S'il s'agit d'un chatbot, vous vous souciez peut-être de l'utilité et de la sécurité. Si c'est classifié, vous vous soucierez probablement de l'exactitude et de la précision. Pour les systèmes qui impliquent plusieurs étapes (comme un système d’IA qui effectue une recherche, hiérarchise les résultats, puis génère une réponse), il est souvent nécessaire d’évaluer chaque étape. L’idée ici est de mesurer si chaque étape contribue à atteindre la mesure de réussite globale (et à partir de là, de comprendre où concentrer les itérations et les améliorations).
Les domaines d’évaluation courants comprennent :
- Exactitude et hallucinations : Les résultats sont-ils réalistes et précis ? Le système génère-t-il des informations erronées ou des hallucinations ?
- Pertinence: Le contenu est-il cohérent avec la requête de l'utilisateur ou le contexte fourni ?
- sécurité, biais et toxicité
- Format: La sortie est-elle au format attendu (par exemple, JSON, appel de fonction valide) ?
- Sécurité, biais et toxicité : Le système génère-t-il du contenu nuisible, biaisé ou toxique ?
Métriques spécifiques à la tâche. Par exemple, dans les tâches de classification, on utilise des métriques telles que l'exactitude et la précision, dans les tâches de résumé, ROUGE ou BLEU, et dans les tâches de création de code, les expressions régulières et la vérification d'exécution sans erreur.
Comment sont réellement calculées les évaluations ?
Une fois que vous avez déterminé ce que vous souhaitez mesurer, l’étape suivante consiste à concevoir vos cas de test. Il s'agira d'un ensemble d'exemples (plus il y en a, mieux c'est, mais toujours en équilibrant la valeur et les coûts) où vous avez :
- Exemple de saisie:Une introduction réaliste de votre système une fois qu'il entre en production.
- Résultats attendus (Le cas échéant) : Fait clé ou exemple des résultats souhaités.
- Méthode d'évaluation : Mécanisme d'enregistrement pour l'évaluation du résultat.
- Résultat ou succès/échec:Une métrique calculée qui évalue votre cas de test.
Selon vos besoins, votre temps et votre budget, il existe plusieurs techniques que vous pouvez utiliser comme méthodes d’évaluation :
- Outils d’enregistrement statistique tels que : BLEU, ROUGE et METEOR, ou mesure de similarité cosinus entre les intégrations – utile pour comparer le texte généré à la sortie de référence.
- Les mesures traditionnelles d'apprentissage automatique telles que Précision, rappel et ASC – Idéal pour la classification avec des données étiquetées.
- Grand modèle linguistique en tant que juge (LLM-as-a-Judge) Utilisez un modèle de langage volumineux pour évaluer la sortie (par exemple, «Cette réponse est-elle correcte et utile ?« ). Particulièrement utile lorsque les données non classifiées ne sont pas disponibles ou lors de l'évaluation d'une construction ouverte.
Les processus d'évaluation basés sur le code utilisent des expressions standard, des règles logiques ou des implémentations de cas de test pour valider les formats.
La ligne du bas
Mettons tout cela ensemble avec un exemple concret. Imaginez que vous construisez un système d’analyse des sentiments pour aider votre équipe de support client à hiérarchiser les e-mails entrants.
L’objectif est de garantir que les messages les plus urgents ou les plus négatifs reçoivent des réponses plus rapides, réduisant ainsi la frustration, améliorant la satisfaction et réduisant le taux de désabonnement des clients. Il s’agit d’un cas d’utilisation relativement simple, mais même dans un système comme celui-ci, avec une production limitée, la qualité est importante : de mauvaises prédictions peuvent conduire à une priorisation aléatoire des e-mails, ce qui signifie que votre équipe perd du temps avec un système qui coûte de l’argent.
Alors, comment savoir si votre solution fonctionne aussi bien que vous le souhaitez ? Vous êtes en train d'évaluer. Voici quelques exemples d’éléments qu’il pourrait être pertinent d’évaluer dans ce cas d’utilisation spécifique :
- Validation du format : Les sorties d’un appel de modèle de langage volumineux (LLM) pour prédire le sentiment des e-mails sont-elles renvoyées au format JSON attendu ? Cela peut être évalué via des vérifications basées sur le code : regex, validation de schéma, etc.
- Précision de la classification des sentiments : Le système classe-t-il correctement les sentiments dans une gamme de textes – courts, longs et multilingues ? Cela peut être évalué à l’aide de données étiquetées à l’aide de mesures d’apprentissage automatique traditionnelles (mesures ML) – ou, si les étiquettes ne sont pas disponibles, en utilisant un grand modèle de langage (LLM) comme juge.
Une fois la solution clairement définie, vous voudrez également inclure les indicateurs les plus pertinents pour l'impact final de votre solution :
- Efficacité de la priorisation : Les agents d’assistance sont-ils réellement dirigés vers les e-mails les plus importants ? La priorisation est-elle en phase avec l’impact commercial souhaité ?
- Impact final sur l'entreprise : Au fil du temps, ce système réduit-il les temps de réponse, réduit-il le taux de désabonnement des clients et améliore-t-il les scores de satisfaction ?
Les évaluations sont essentielles pour garantir que les systèmes d'IA sont utiles, sécurisés, performants et prêts pour la production. Par conséquent, que vous travailliez avec un simple classificateur ou un chatbot à questions ouvertes, prenez le temps de définir ce que signifie « suffisant » (la qualité minimale acceptable) et concevez vos évaluations en conséquence pour mesurer les performances !
Références
[1] Votre produit d'IA a besoin d'évaluations , Hamel Husain
[2] Métriques d'évaluation des LLM : Le guide ultime d'évaluation des LLM, Confident AI
[3] Évaluation des agents d'IA, deeplearning.ai + Arize
Les commentaires sont fermés.