

Explication : Comment la régularisation L1 sélectionne-t-elle automatiquement les fonctionnalités ?
Comprendre le processus de sélection automatique des fonctionnalités effectué par la régularisation L1 (LASSO).
La sélection de fonctionnalités est le processus de sélection d’un sous-ensemble optimal de fonctionnalités à partir d’un ensemble donné de fonctionnalités ; Le sous-ensemble optimal est celui qui maximise les performances du modèle sur la tâche donnée.
La sélection de caractéristiques peut être manuelle ou, plus précisément, explicite lorsqu'elle est réalisée à l'aide de méthodes de filtrage ou d'encapsulation . Ces méthodes consistent à ajouter ou supprimer des caractéristiques de manière itérative en fonction d'une métrique fixe, qui détermine leur importance pour les prédictions. Ces métriques peuvent être le gain d'information, la variance ou le test du χ², et l'algorithme décide d'accepter ou de rejeter une caractéristique selon un seuil prédéfini de cette métrique. Il est important de noter que ces méthodes ne font pas partie de la phase d'entraînement du modèle et sont appliquées en amont.
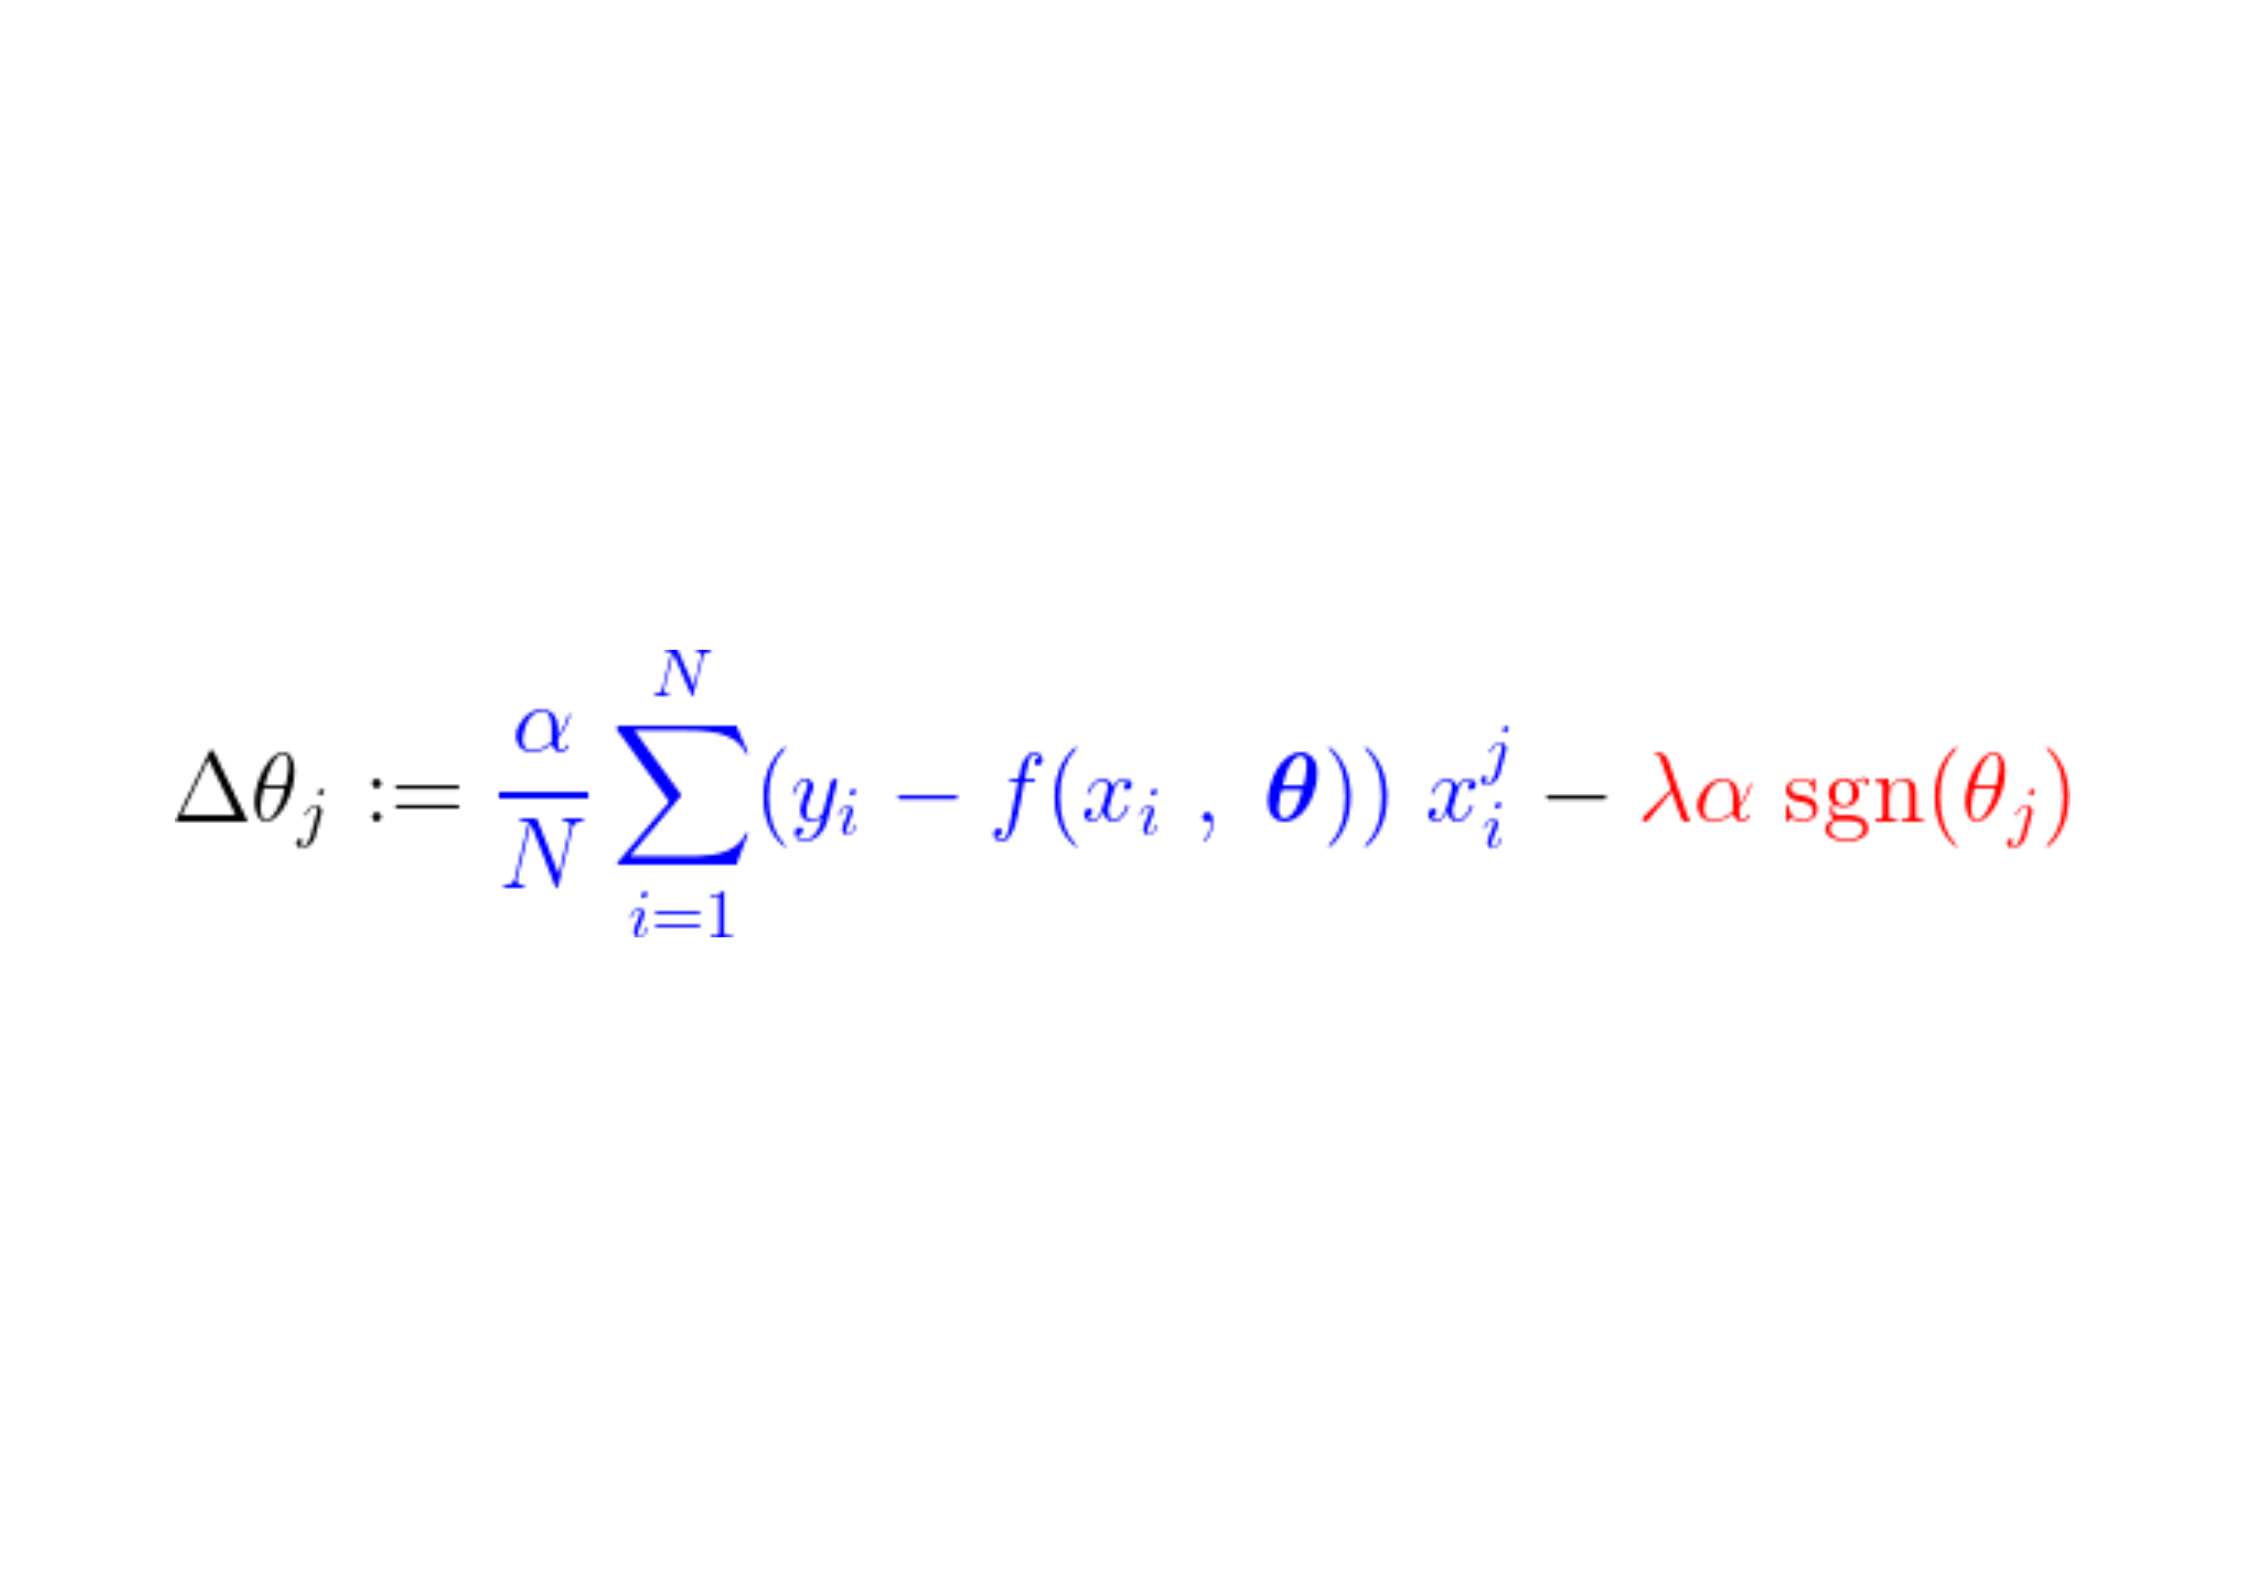
Les méthodes intégrées identifient implicitement les caractéristiques, sans critères de sélection prédéfinis, et les extraient directement des données d'entraînement. Ce processus d'identification des caractéristiques intrinsèques fait partie de la phase d'entraînement du modèle. Ce dernier apprend à identifier les caractéristiques et à effectuer des prédictions associées simultanément. Dans les sections suivantes, nous décrirons le rôle de la régularisation dans ce processus d'identification des caractéristiques intrinsèques, en nous concentrant sur la régularisation L1 et son impact sur l'amélioration des modèles d'apprentissage automatique.
Normalisation et complexité des modèles : stratégies avancées pour améliorer les performances
La régularisation est le processus de pénalisation de la complexité du modèle pour éviter le surajustement et parvenir à une généralisation à la tâche.
Ici, la complexité du modèle est analogue à sa capacité d'adaptation aux régularités des données d'entraînement. Prenons l'exemple d'un modèle polynomial simple en « x » de degré « d ». Plus le degré « d » du polynôme est élevé, plus le modèle est flexible pour identifier les régularités des données observées. Cette flexibilité accrue peut amener le modèle à mémoriser les données d'entraînement plutôt qu'à apprendre les régularités réelles, réduisant ainsi sa capacité de généralisation à de nouvelles données.
Sur-apprentissage et sous-apprentissage
Lorsqu'on tente d'ajuster un modèle polynomial de degré d = 2 à un ensemble d'échantillons d'apprentissage issus d'un polynôme de degré 3 bruité, le modèle ne parvient pas à reproduire correctement la distribution des échantillons. Il manque tout simplement de la flexibilité ou de la complexité nécessaires pour modéliser des données générées par des polynômes de degré 3 (ou supérieur). On dit alors que ce modèle est sous-ajusté aux données d'apprentissage. Le sous-ajustement indique que le modèle est trop simpliste et incapable de saisir les structures sous-jacentes des données.
Reprenons l'exemple d'un modèle de degré d = 6. Avec une complexité accrue, le modèle devrait facilement estimer le polynôme cubique initial utilisé pour générer les données (par exemple, en annulant les coefficients de tous les termes d'exposant supérieur à 3). Si l'apprentissage n'est pas interrompu à temps, le modèle continuera d'exploiter sa flexibilité accrue pour réduire davantage l'erreur et commencera à intégrer des échantillons de bruit. Cela réduira considérablement l'erreur d'apprentissage, mais le modèle souffrira alors d'une surcharge des données d'entraînement. Le bruit évoluera dans des conditions réelles (ou lors des tests), et toute connaissance basée sur les prédictions sera perturbée, entraînant une erreur de test élevée. La surcharge signifie que le modèle est trop complexe et apprend le bruit au lieu du signal réel.
Comment déterminer la complexité optimale du modèle ?
Dans la pratique, nous avons souvent une compréhension limitée, voire inexistante, du processus de génération de données ou de la véritable distribution des données. Trouver le modèle optimal avec la complexité appropriée, de sorte qu'il n'y ait pas de sous-ajustement ou de surajustement, est un défi important. Cela nécessite l’utilisation de méthodes efficaces pour évaluer les performances des modèles et déterminer la complexité appropriée qui permet d’obtenir le meilleur équilibre entre précision et généralité. En utilisant des mesures et des techniques d’évaluation appropriées telles que la validation croisée, les professionnels peuvent identifier le modèle qui fonctionne le mieux sur des données invisibles, évitant ainsi les problèmes de sur- ou de sous-ajustement.
Une technique possible consiste à commencer avec un modèle suffisamment robuste, puis à réduire sa complexité par sélection de fonctionnalités. Moins il y a de fonctionnalités, moins le modèle est complexe.
Comme nous l’avons vu dans la section précédente, la sélection de fonctionnalités peut être explicite (méthodes de filtrage, méthodes de convolution) ou implicite. Les fonctionnalités redondantes qui ne sont pas très importantes pour déterminer la valeur de la variable cible doivent être supprimées pour éviter que le modèle n'apprenne des modèles non corrélés. La régularisation accomplit également une tâche similaire. Alors, comment la régularisation et la sélection de fonctionnalités sont-elles liées à la réalisation d’un objectif commun de complexité optimale du modèle ? La réduction de la complexité des modèles d’apprentissage automatique est essentielle pour améliorer les performances et éviter le surapprentissage, sur lequel se concentrent la régularisation et la sélection de fonctionnalités.
La régularisation L1 comme déterminant de caractéristique
En continuant avec notre modèle polynomial, nous le représentons comme une fonction de f, avec des entrées x , des coefficients θ et un degré d ,
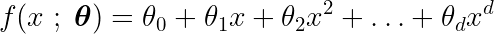
Pour le modèle polynomial, chaque puissance de l'entrée x_i peut être considérée comme une caractéristique, formant un vecteur comme suit :
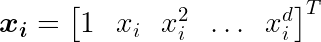
Nous définissons également une fonction objectif, dont la réduction conduit aux paramètres idéaux θ* et inclut le terme de régularisation , qui pénalise la complexité du modèle.
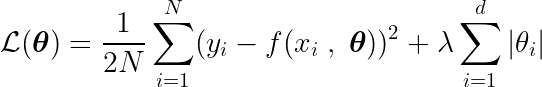
Pour trouver le minimum de cette fonction, nous devons analyser tous les points critiques, c'est-à-dire les points où la dérivée est nulle ou indéfinie.
La dérivée partielle par rapport à l'un des paramètres, θj , peut s'écrire comme suit :
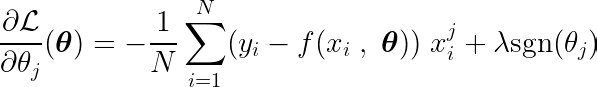
La fonction sgn est définie comme suit :
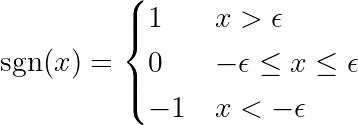
Remarque : La dérivée d'une fonction absolue diffère de la fonction signe (sgn) définie ci-dessus. La dérivée initiale n'est pas définie en x = 0. Nous étendons la définition afin de supprimer le point d'inflexion en x = 0 et de rendre la fonction différentiable sur tout son domaine. De plus, les frameworks d'apprentissage automatique (ML) utilisent ces fonctions étendues lorsque des opérations arithmétiques de base impliquent la valeur absolue. Consultez ce lien sur le forum PyTorch.
En calculant la dérivée partielle de la fonction objectif par rapport à un seul coefficient θj et en la fixant à zéro, nous pouvons construire une équation qui relie la valeur optimale de θj aux prédictions, aux objectifs et aux caractéristiques.
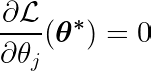
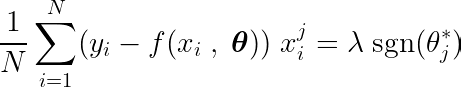
Examinons l'équation ci-dessus. Si l'on suppose que les entrées et les cibles étaient centrées autour de la moyenne (c'est-à-dire que les données ont été standardisées lors de l'étape de prétraitement), alors le terme de gauche (LHS) représente effectivement la variance entre la caractéristique numéro j et la différence entre les valeurs attendues et les valeurs cibles.
La covariance statistique entre deux variables détermine le degré d’influence d’une variable sur la valeur de la deuxième variable (et vice versa).
La fonction signe, à droite, contraint la variance, à gauche, à ne prendre que trois valeurs (puisqu'elle ne renvoie que -1, 0 et 1). Si la variable j est inutile et n'influence pas les prédictions, sa variance sera proche de zéro, ce qui annulera le coefficient correspondant θj* . La variable est alors supprimée du modèle. Ce processus permet de réduire sa complexité et d'améliorer ses performances.
Imaginez la fonction du signe comme un sillon creusé par l’eau. Vous pouvez marcher dans le ravin (c'est-à-dire dans le lit de la rivière), mais pour en sortir, vous rencontrerez d'énormes barrières ou des rapides abrupts. La régularisation L1 crée un effet de « seuil » similaire au gradient de la fonction de perte. Le gradient doit être suffisamment fort pour briser les barrières ou devenir nul, ce qui rendrait finalement la valeur du coefficient nulle.
Pour fournir un exemple plus réaliste, considérons un ensemble de données contenant des échantillons dérivés d’une ligne droite (paramétrée à deux facteurs) avec un peu de bruit ajouté. Le modèle optimal ne doit pas avoir plus de deux paramètres, sinon il s'adaptera au bruit dans les données (avec la liberté/puissance supplémentaire du polynôme). La modification des coefficients de puissance supérieurs dans un modèle polynomial n’affecte pas la différence entre les cibles et les prédictions du modèle, et réduit ainsi leur variance avec la fonctionnalité.
Au cours du processus de formation, une étape fixe est ajoutée/soustraite du gradient de la fonction de perte. Si le gradient de la fonction de perte (MSE – erreur quadratique moyenne) est inférieur au pas constant, le coefficient atteindra finalement une valeur de 0. Notez l'équation ci-dessous, qui décrit comment les coefficients sont mis à jour à l'aide de la descente de gradient :

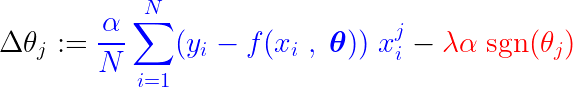
Si la partie bleue ci-dessus est inférieure à λα , qui est lui-même un nombre très petit, alors Δθj est approximativement un pas constant de λα . Le signe de ce pas (la partie rouge) dépend de sgn(θj) , dont la sortie dépend de θj . Si la valeur de θj est positive, c'est-à-dire supérieure à ε , alors sgn(θj) vaut 1, ce qui rend Δθj approximativement égal à -λα , le rapprochant ainsi de zéro.
Pour supprimer le pas constant (partie rouge) qui rend le coefficient nul, le gradient de la fonction de perte (partie bleue) doit être supérieur à la taille du pas. Pour obtenir un gradient plus important pour la fonction de perte, la valeur de la fonctionnalité doit affecter de manière significative la sortie du modèle.
C'est ainsi que la fonctionnalité, ou plus précisément son paramètre correspondant, dont la valeur n'est pas liée à la sortie du modèle, est mise à zéro par la régularisation L1 pendant l'entraînement.
Lectures complémentaires et conclusion
- Pour obtenir plus d'informations sur ce sujet, j'ai posté une question sur Reddit r/MachineLearning, etSuivi Il contient différentes interprétations que vous voudrez peut-être lire.
- Madiyar Aitbayev a également blog intéressant Couvre la même question, mais avec une explication technique.
- مدونة Brian King explique l’organisation d’un point de vue probabiliste.
- هذا النقاش Sur le site CrossValidated, il explique pourquoi le critère L1 encourage les modèles clairsemés. مدونة Un article détaillé de Mukul Ranjan explique pourquoi la norme L1 encourage les transactions à devenir nulles et la norme L2 ne le fait pas.
« La régularisation L1 sélectionne les caractéristiques » est une affirmation simple sur laquelle la plupart des spécialistes de l'apprentissage automatique s'accordent, sans pour autant s'attarder sur son fonctionnement interne. Ce blog vise à partager ma compréhension et mon modèle mental afin de répondre intuitivement à cette question. Pour toute suggestion ou question, vous trouverez mon adresse courriel sur mon site web . Continuez d'apprendre et passez une excellente journée !
Les commentaires sont fermés.